


Qualche giorno fa la ricercatrice Diletta Huyskes ha condiviso questa foto che credo possa incarnare le pulsioni di chiunque si occupi di tecnologia e intelligenza artificiale.
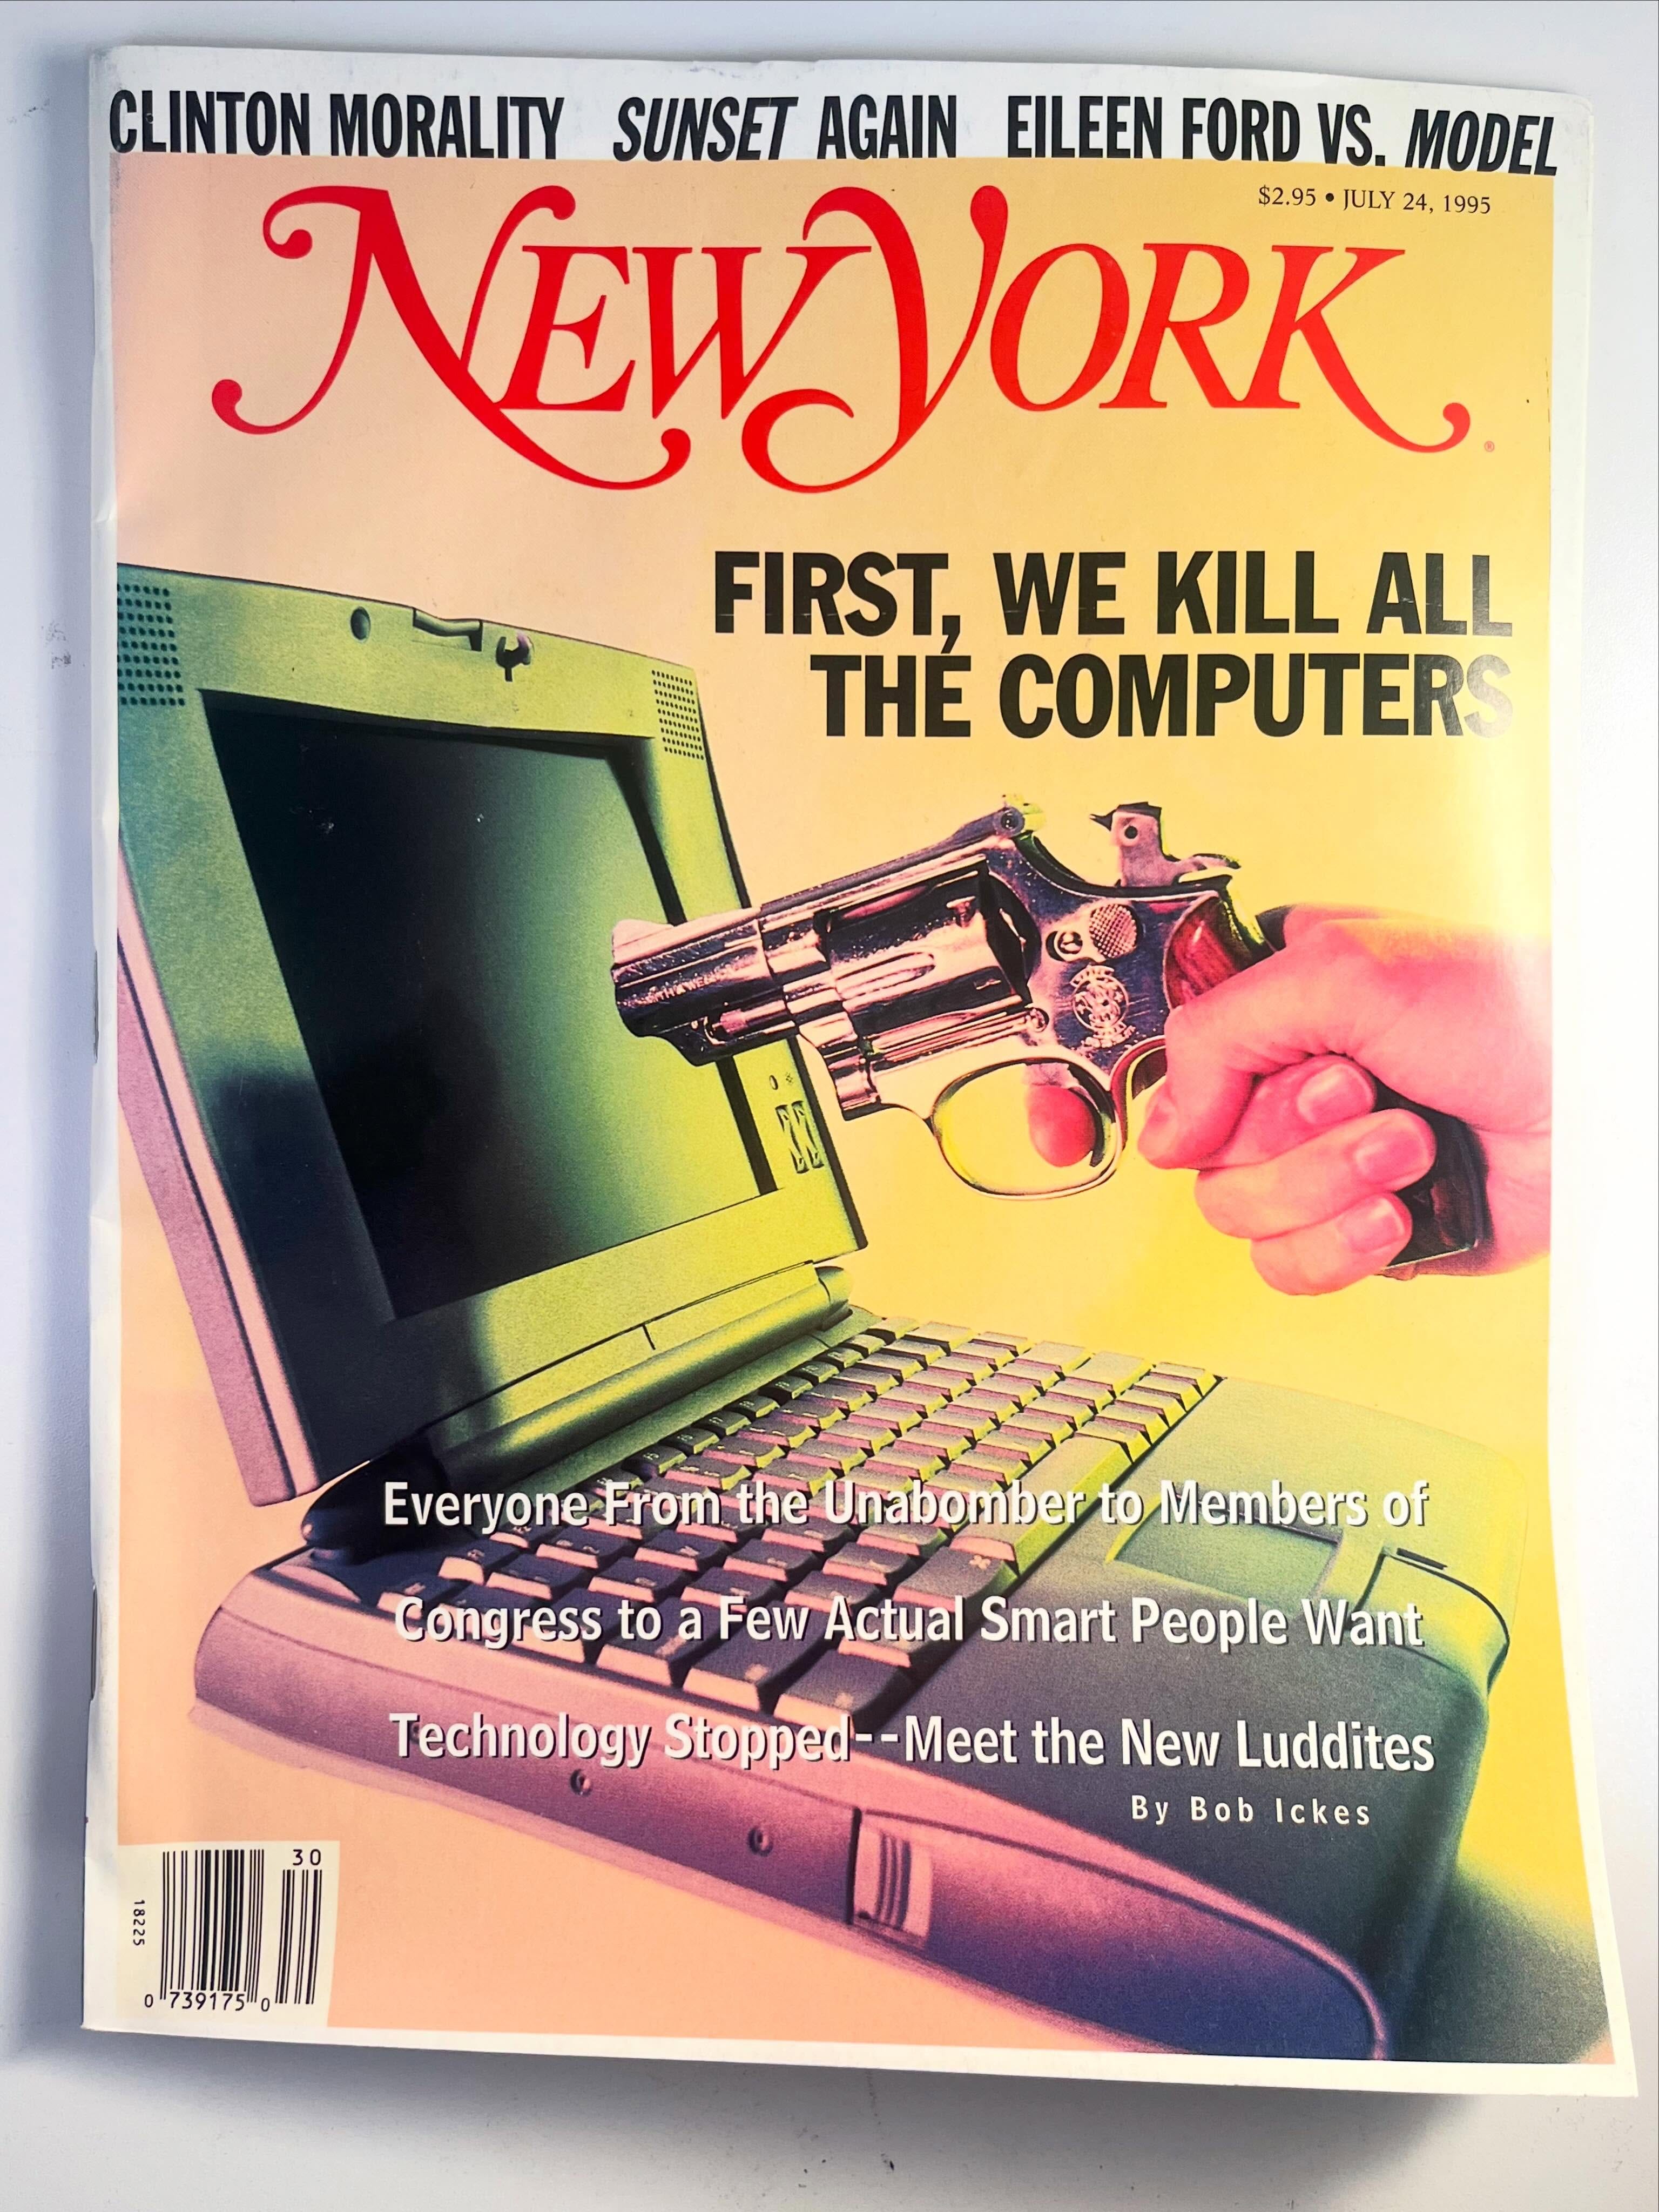
Tra annunci di apocalisse imminente (Diletta ha deciso di monitorarli dentro un osservatorio), errori umani per cui non sappiamo a chi chiedere conto, inchieste che dimostrano come affidarsi esclusivamente all’IA possa letteralmente uccidere (123 bambini in Iran), non c’è davvero altro modo di pensare come l’IA? Sto progettando un workshop per attivisti e per organizzazioni del terzo settore sul tema, approfitto di questa newsletter per prendere appunti.
Dove mi trovi prossimamente
30 settembre, stasera a Imola: presentazione del libro con l’associazione Trama di Terre.
8 ottobre, Roma: alle 12 alla presentazione del dossier inDifesa di Terre des Hommes presso la sede di Anci.
11 ottobre, Pisa: una domenica all’Internet festival.
13 ottobre, Torino: alle 18:30 un evento al Circolo dei lettori su Revenge porn, cyberbullismo, con Vera Gheno.
16 ottobre, Tavagnacco: ecco un altro posto dove portare le mie riflessioni sull’IA, all’AI Forum.
17 ottobre, Bologna: alle 16 un talk su “Chi possiede i nostri dati?” al Tecnopolis.
Cosa ho scritto (o cosa ho detto)
Su SkyTg24 racconto che i defibrillatori possono salvare una vita nei pochi minuti che separano un arresto cardiaco dall’arrivo dei soccorsi. Ma per farlo devono essere localizzabili, accessibili e utilizzabili: e in Italia non sempre lo sono.
Come si racconta una storia con i dati: per Zanichelli lo spiego in un articolo lunghissimo e spero utile, anche da usare in classe.
Sei tra le 15394 persone che leggono la newsletter. Nell’ultima puntata ho parlato delle metriche dei nazisti e questo ha fatto disiscrivere almeno venti persone. Non le rimpiangeremo :)

Ti piace questa newsletter? Riconosci il lavoro che c’è dietro? Puoi sostenerla con un abbonamento, costa 51€ l’anno (ma con questo bottone hai lo sconto del 10%).
“Non sei la tua idea e, se ti identifichi troppo con le tue idee, ti sentirai offesa quando verranno messe in discussione”
Ed Catmull, Verso la creatività e oltre (Sperling & Kupfer 2014)
Small AI contro big AI, ha senso?
Vi ricordate degli small data? È una delle parole che nel suo manifesto per l’umanesimo dei dati la designer italiana Giorgia Lupi (qui racconto quando l’ho incontrata) ha contrapposto al mito dei “big data”. Sono dati molto spesso qualitativi e osservabili a occhio nudo, e dovrebbero restituire contesto, significato e un volto umano alle statistiche.
Io ho sempre preferito parlare di thick data1, perché più che la dimensione mi interessa capire cosa fanno questi dati diversamente grandi. Ci offrono densità, ci spiegano perché accade qualcosa, non mostrano solo che sta accadendo.
Può esistere allora una small IA?
Ne ho sentito parlare per la prima volta leggendo un articolo sul blog della Banca Mondiale, che elogiava l’uso di sistemi di intelligenza artificiale progettati per un compito specifico, abbastanza efficienti da funzionare con poca energia e connessione intermittente, su smartphone non sempre aggiornati, e basati sulle lingue e sulle condizioni ma soprattutto sui bisogni locali.
Alcuni dati (fonte Rest of the world e WB): nel 2025 almeno un quarto degli utenti internet dei paesi ad alto reddito usava l’IA generativa, mentre nei paesi a basso reddito quella cifra era meno dell’1%. Ma, i paesi ad alto reddito, che ospitano il 17% della popolazione mondiale, concentrano l’87% dei modelli di IA rilevanti, l’86% delle startup e il 91% dei finanziamenti di venture capital. Anche per l'infrastruttura le percentuali sono simili: a giugno 2025 il “nord globale” ospitava il 77% della capacità globale dei data center, contro meno dello 0,1% dei paesi a basso reddito. Però, più del 40% del traffico globale di ChatGPT arriva da paesi a reddito medio, con Brasile, India, Indonesia e Vietnam in testa.
Cosa fa quindi una piccola IA? In alcuni casi citati dalla Banca Mondiale emerge l’esigenza di costruire propri modelli linguistici, quando la lingua e la cultura di una comunità non sono rappresentate a sufficienza in GPT, Gemini, Claude o Qwen (Alibaba). Ma in generale uno small language model (SLM) è un sistema compatto, con un numero limitato di parametri (da centinaia di milioni ad alcuni miliardi), pensato per compiti linguistici specifici come l’assistenza alla programmazione, la traduzione automatica o la sintesi di testi. Alcuni esempi citati nel report della BM:
in Nigeria, dove c'è un medico ogni 9mila pazienti, quindici volte il rapporto raccomandato dall'Organizzazione mondiale della sanità, una startup locale ha costruito uno strumento vocale che trascrive e struttura le note cliniche mentre il medico parla, così da ridurre il tempo passato sul lavoro amministrativo. Funziona offline, su un piccolo computer installato direttamente nel reparto;
in Kenya una startup ha inserito la propria IA dentro M-Pesa, il servizio di pagamenti da telefono, in modo che i dati delle transazioni dei piccoli commercianti diventino indicazioni sull'andamento della loro attività. I commercianti non devono installare una nuova app né imparare una nuova interfaccia, e secondo l’analisi della Banca Mondiale questo li aiuta ad aumentare i guadagni;
in India un'app per lo screening della tubercolosi dalla tosse ha già testato oltre 120mila pazienti e aumentato le diagnosi corrette fino al 16%.
La domanda che resta però è: chi controlla il modello e i dati con cui sono prodotti questi piccoli sistemi di IA?
Sicuramente la porterò al workshop. Ma su Rest of World ho scoperto le data collective, o collettivi per i dati2: mentre le grandi aziende dell’IA hanno raccolto dal web quasi tutto ciò che era disponibile per addestrare i propri modelli e sono state accusate di usare materiale protetto da copyright senza consenso, una cooperativa di dati funziona in modo diverso.
È la comunità a decidere come i dati vengono raccolti, gestiti e distribuiti.
Mi ricorda il principio della sovranità dei dati del movimento indigeno.

Meesum Alam, dottorando in linguistica computazionale all’Indiana University, ha raccolto in Pakistan circa 700 ore di registrazioni vocali in 39 lingue, tra cui il dawoodi, parlato da circa trecento persone, e le ha pubblicate su Mozilla Data Collective. Le persone coinvolte hanno deciso insieme che i dati potranno essere utilizzati solo per la ricerca o per scopi non commerciali. Aziende come Meta, che hanno sfruttato questi dati per costruire strumenti di riconoscimento vocale, hanno dovuto negoziare le condizioni di utilizzo. Secondo il ricercatore, il denaro non è la motivazione principale di questo approccio: le comunità vogliono un accordo equo, che a suo parere si può ottenere solo attraverso un lavoro “collettivo”.
Anche Catherine D’Ignazio, quando ha lavorato al suo Counting feminicide, ha elaborato un protocollo di ricerca affinché il controllo dei dati dei movimenti che contano i femminicidi rimanesse in loro gestione.
Nello sviluppo di un’IA alternativa, oltre ai protocolli open source e alla trasparenza, introdurre i concetti di collettività, consenso, sovranità, potrebbe darci soddisfazione, ed evitare di farci lanciare il computer dalla finestra.
La dataviz della settimana
A proposito di IA, l’altra domanda che possiamo farci è: dobbiamo davvero usarla? E quando? Aiuta o blocca il processo creativo? Giorgia Lupi ci ha riflettuto e ha scritto e disegnato un editoriale per il New York Times.

Ti ricordo che se vuoi coinvolgermi in un evento puoi scrivere a contact-columbro@elastica.eu.
Per promuovere il prodotto della tua azienda, un evento o un corso in questi spazi scrivi a newsletter@tispiegoildato.it, rispondo io oppure Roberta.
A mercoledì!
Tricia Wang è stata una delle prime a introdurre questo termine che arriva dall’antropologia nel mondo del marketing.
Meglio collettivi di dati? Cooperative? Anche chatgpt era indeciso sulla traduzione. Se ci immaginiamo il “collettivo” come a scuola secondo me è perfetto.